Verifier도 틀릴 수 있다 — Stanford CS329A Part 3 Robust Verification
Stanford CS329A Part 3를 따라 outcome verifier, process reward model, Math-Shepherd, weak-verifier ensemble과 distillation까지 검증 기술의 진화를 살펴본다.
Stanford CS329A Part 3를 따라 outcome verifier, process reward model, Math-Shepherd, weak-verifier ensemble과 distillation까지 검증 기술의 진화를 살펴본다.
Stanford CS329A Part 2를 따라 repeated sampling, verifier bottleneck, compute-optimal inference, Archon까지 살펴보면 test-time scaling은 결국 연산 배분 문제라는 점이 드러난다.
Stanford CS329A Part 1을 따라 사전학습 스케일링에서 CoT, post-training, test-time compute, verifier, agentic feedback loop로 이어지는 변화를 자세히 살펴본다.
Stanford CS329A의 9편 강의를 관통해 보면 자가 개선 AI의 핵심은 더 큰 모델 하나보다 탐색·검증·도구·학습·평가를 연결하는 닫힌 피드백 루프에 가깝다.
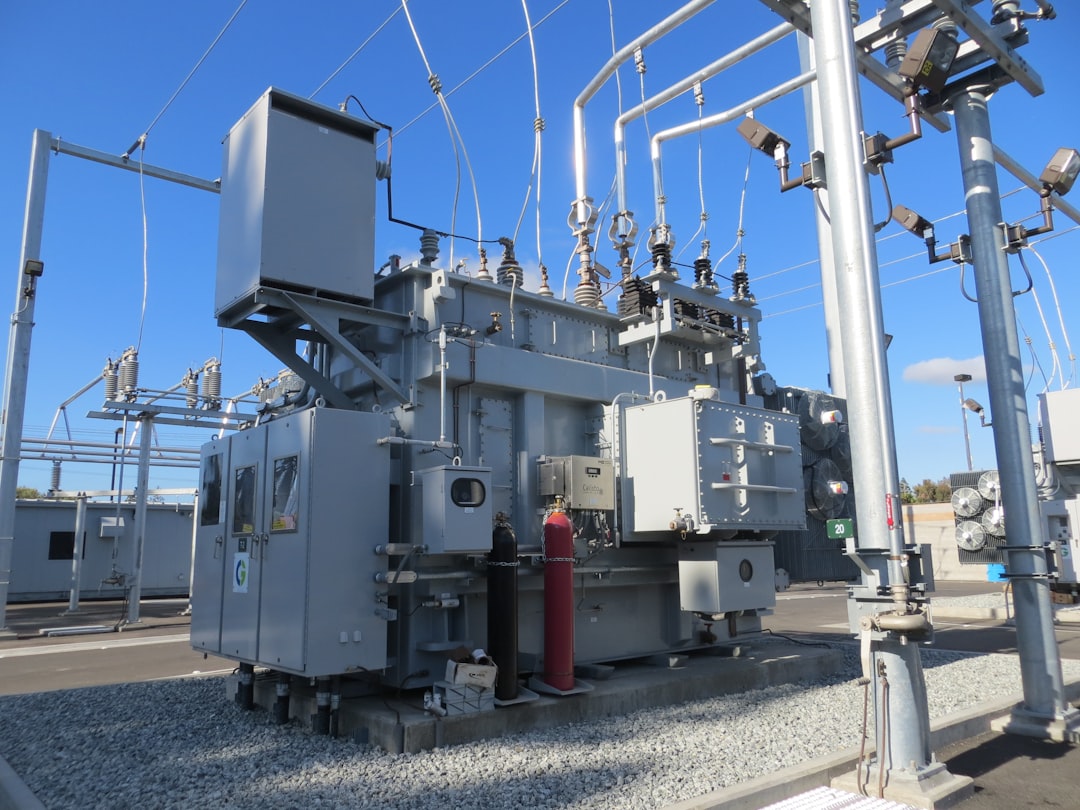
AI 데이터센터의 전력 문제는 발전량만의 문제가 아니다. 필요한 전력을 얼마나 빨리 연결할지, 그리고 신규 전력망 비용과 위험을 누가 부담할지가 새로운 핵심 쟁점이 되고 있다.
AI가 한 단계의 비용을 낮춘다고 전체 시스템이 같은 속도로 빨라지는 것은 아니다. 스타트업, 행정, AI 연구를 함께 보면 새롭게 비싸지는 일이 보인다.